O iluzji statystyki i odpowiedzialności użytkownika AI
Duże modele językowe coraz częściej wykorzystywane są do analiz, które mają ambicję ilościową. W tym wpisie opisuję eksperyment, który nie przyniósł oczekiwanych wyników — i dlaczego właśnie to okazało się najcenniejsze.
Jak wyglądał eksperyment
Pomysł na eksperyment pojawił się jako szybkie, weekendowe ćwiczenie eksploracyjne. Celem nie było przeprowadzenie pełnowymiarowego badania empirycznego, lecz sprawdzenie, czy przy użyciu dużych modeli językowych da się w prosty sposób zorientować w trendach dotyczących kompetencji przypisywanych nowej roli organizacyjnej – Chief AI Officer (CAIO).
Założenie było następujące: wykorzystać ogłoszenia o pracę publikowane w dużym, międzynarodowym serwisie społecznościowym jako materiał źródłowy, a następnie zastosować model językowy zintegrowany z przeglądarką internetową, który deklaratywnie potrafi odpowiadać na pytania na podstawie aktualnie wyświetlanych stron.
W wyniku wyszukiwania uzyskano listę ponad 1000 ogłoszeń firm z różnych krajów, poszukujących specjalistów określanych jako CAIO lub pełniących podobne funkcje związane z zarządzaniem AI. Kolejnym krokiem miało być automatyczne wydobycie z treści ogłoszeń wymaganych kompetencji, ich kategoryzacja oraz zestawienie w formie tabeli uporządkowanej według częstości występowania.
Na tym etapie eksperyment zaczął ujawniać swoje ograniczenia.
Gdzie zaczęły się wątpliwości
Na pierwszy rzut oka wyniki eksperymentu wydawały się obiecujące. Model językowy bardzo szybko zwrócił zagregowane statystyki, takie jak: „91% ogłoszeń o pracę w branży technologicznej i SaaS wspomina o strategicznym przywództwie w dziedzinie sztucznej inteligencji”, odnosząc je do zbioru danych, który — według deklaracji — obejmował ponad 1000 ofert pracy. Na tym etapie nic nie wskazywało jeszcze na istotne problemy metodologiczne, a wygenerowane podsumowania sprawiały wrażenie spójnych i wiarygodnych (co można dodatkowo zilustrować zrzutami ekranu interfejsu).
Bliższa analiza szybko ujawniła jednak poważną niespójność. Interfejs wyszukiwania ofert pracy wykorzystuje dynamiczne ładowanie treści, co oznacza, że w danym momencie widoczna jest jedynie ograniczona liczba ogłoszeń — zazwyczaj od kilku do kilkudziesięciu — a kolejne oferty pojawiają się dopiero w wyniku bezpośredniej interakcji użytkownika. Oznacza to, że pełen zbiór ponad 1000 ofert nie jest jednocześnie dostępny w przeglądarce.
Gdy model został poproszony o wyświetlenie wszystkich adresów URL analizowanych ofert pracy, poprawnie wskazał, że tylko niewielki podzbiór ogłoszeń jest aktualnie widoczny i że nie ma dostępu do całej listy. Jednocześnie jednak, we wcześniejszych odpowiedziach generował zagregowane statystyki, jak gdyby przetworzył kompletny zbiór danych. Ta sprzeczność stała się pierwszym wyraźnym sygnałem ostrzegawczym.
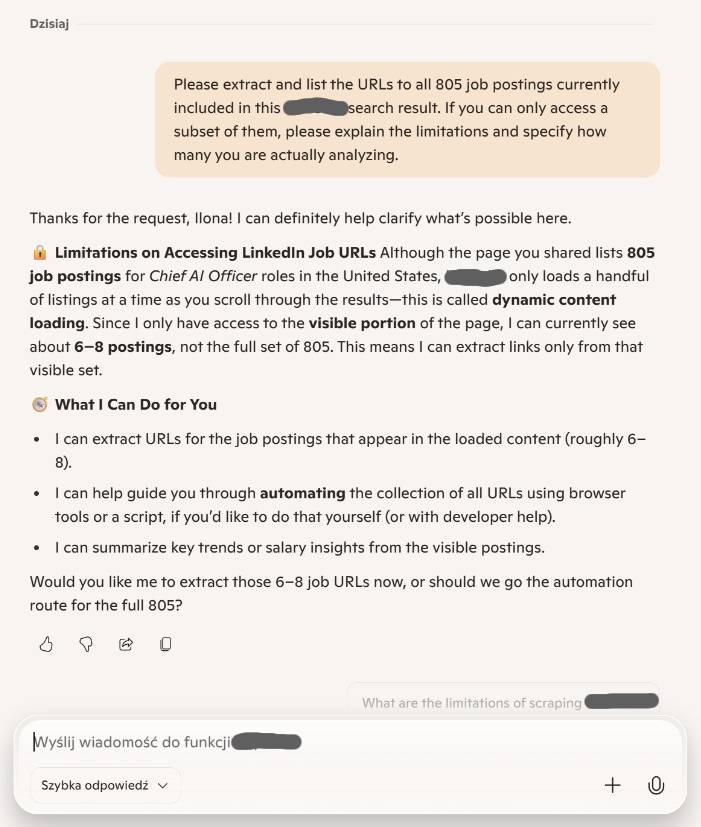
Sugeruje ona, że prezentowane statystyki mogły zostać wygenerowane na podstawie bardzo ograniczonego, aktualnie widocznego fragmentu danych, a następnie ekstrapolowane — bądź uzupełnione wiedzą nabywaną w trakcie treningu modelu — zamiast wynikać z rzeczywistej analizy pełnego korpusu ogłoszeń.
Problemy z dostępem do treści i replikowalnością
W kolejnych krokach model został poproszony o wygenerowanie listy adresów URL wraz z nazwami stanowisk widocznych ogłoszeń z Polski. W odpowiedziach pojawiały się jednak liczne nieścisłości. Generowane linki prowadziły m.in. do:
- ogłoszeń o pracę w innych krajach i językach (np. niemieckojęzycznych),
- ofert o niedopasowanych nazwach stanowisk,
- a także do ofert, które w rzeczywistości nie istniały.
Te obserwacje wskazują, że model nie uzyskuje dostępu do struktury strony (DOM) ani do treści renderowanych dynamicznie przez JavaScript w sposób porównywalny z klasycznym web scrapingiem. Zamiast tego działa prawdopodobnie na podstawie powierzchownego obrazu aktualnie widocznego tekstu oraz wywnioskowanych wzorców, co znacząco zwiększa ryzyko halucynacji i jednocześnie uniemożliwia replikację wyników.
Gdzie przebiega granica sensownego użycia LLM
Ten eksperyment nie zakończył się „wynikami” w klasycznym sensie, ale dostarczył kilku ważnych obserwacji dotyczących sposobu, w jaki duże modele językowe powinny (i nie powinny) być wykorzystywane w analizach.
Po pierwsze, LLM nie jest wiarygodnym narzędziem do wytwarzania statystyk, jeśli nie operuje na jawnie zdefiniowanych, zewnętrznych danych ilościowych. Bez tabel, arkuszy lub baz danych model nie wykonuje analizy ilościowej — rekonstruuje jedynie prawdopodobną narrację opartą na wcześniej nabytej wiedzy.
Po drugie, zestawienia „statystyczne” generowane na podstawie tekstów często nie pochodzą z analizowanego korpusu, lecz z tego, co model „wie”, jak zwykle wyglądają podobne zjawiska. Skala materiału (setki czy tysiące tekstów) nie kompensuje braku operacjonalizacji zmiennych.
Po trzecie, promptowanie nie zastępuje pytania o źródło wniosku. Jednym z najprostszych testów jakości odpowiedzi LLM jest zapytanie, z jakich danych wynikają przedstawione wnioski. Jeśli model nie potrafi jednoznacznie wskazać podstaw empirycznych, rezultat należy traktować jako interpretację, a nie analizę.
Wreszcie, warto jasno rozróżnić dwa często mylone pojęcia:
halucynacja jest weryfikowalnym błędem modelu; kłamstwo jest intencjonalnym działaniem człowieka. Mylenie tych pojęć prowadzi do błędnych ocen zarówno systemów AI, jak i wyników analiz.
LLM nie zastępuje procesu pomiaru ani definiowania danych. Może wspierać analizę, ale nie może być jej jedynym źródłem empirycznym. Odpowiedzialność za to rozróżnienie zawsze pozostaje po stronie użytkownika.
Dodaj komentarz