✏️Słowo wstępu
Regresja hierarchiczna to prosta, ale niezwykle użyteczna metoda, która pozwala zrozumieć, jak kolejne grupy czynników wpływają na badane zjawisko.
Zamiast wrzucać wszystkie zmienne naraz, budujemy model krok po kroku — i sprawdzamy, czy nowe zmienne naprawdę poprawiają dopasowanie modelu.
W tym wpisie pokażę, jak można zastosować tę metodę na rzeczywistych danych z raportu World Happiness Report 2015, aby odpowiedzieć na pozornie banalne pytanie:
czy szczęście narodów zależy tylko od pieniędzy, czy również od relacji, zdrowia i wolności?
👉 Jeśli nie czytałaś/eś mojego wcześniejszego wpisu „Jak dobrać odpowiedni rodzaj regresji? Praktyczny przewodnik, warto tam zajrzeć – znajdziesz w nim krótkie przypomnienie podstawowych typów regresji i wskazówki, kiedy który model warto zastosować.
📘 Wprowadzenie do zbioru danych
Zbiór pochodzi z raportu World Happiness Report 2015, który klasyfikuje kraje świata według poziomu odczuwanego szczęścia.
Plik do analiz pobrałam z: https://www.kaggle.com/datasets/unsdsn/world-happiness https://www.kaggle.com/datasets/unsdsn/world-happiness
Każdy wiersz reprezentuje jeden kraj, a kolumny opisują różne czynniki, które mogą wpływać na jego wynik w rankingu szczęścia.
🧩 Struktura danych
| Nazwa kolumny | Opis | Typ danych | Przykład |
|---|---|---|---|
Country | Nazwa kraju | tekst | Switzerland |
Region | Region geograficzny | tekst | Western Europe |
Happiness Rank | Pozycja kraju w rankingu (1 = najwyższe szczęście) | liczba całkowita | 1 |
Happiness Score | Średni poziom szczęścia w skali 0–10 | liczba zmiennoprzecinkowa | 7.587 |
Standard Error | Błąd standardowy pomiaru szczęścia | liczba zmiennoprzecinkowa | 0.03411 |
Economy (GDP per Capita) | Wskaźnik dobrobytu ekonomicznego (PKB per capita) | liczba zmiennoprzecinkowa | 1.39651 |
Family | Wskaźnik wsparcia społecznego (poczucie, że można liczyć na innych) | liczba zmiennoprzecinkowa | 1.34951 |
Health (Life Expectancy) | Oczekiwana długość życia w zdrowiu | liczba zmiennoprzecinkowa | 0.94143 |
Freedom | Wskaźnik wolności podejmowania decyzji życiowych | liczba zmiennoprzecinkowa | 0.66557 |
Trust (Government Corruption) | Poziom zaufania do instytucji publicznych (odwrotność korupcji) | liczba zmiennoprzecinkowa | 0.41978 |
Generosity | Wskaźnik hojności obywateli | liczba zmiennoprzecinkowa | 0.29678 |
Dystopia Residual | Część wyniku szczęścia, której nie wyjaśniają powyższe zmienne (rezerwa dla porównań) | liczba zmiennoprzecinkowa | 2.51738 |
🎯 Cel analizy
W regresji hierarchicznej będziemy badać, które grupy czynników w największym stopniu wyjaśniają poziom szczęścia (Happiness Score).
Proponowany układ:
- Model 1: czynniki ekonomiczne →
Economy (GDP per Capita) - Model 2: + czynniki społeczne →
Family,Health (Life Expectancy) - Model 3: + czynniki psychologiczne i kulturowe →
Freedom,Trust,Generosity
💰Model 1 – czynniki ekonomiczne
Poniżej kod w Pythonie, który wczytuje dane z pliku 2015.csv, oblicza Model 1 i wyświetla wyniki.
mport statsmodels.api as sm
import pandas as pd

# Wczytanie przesłanego pliku
file_path = "2015.csv"
df = pd.read_csv(file_path)
# Model 1: tylko czynnik ekonomiczny (PKB per capita)
X1 = sm.add_constant(df["Economy (GDP per Capita)"])
y = df["Happiness Score"]

model1 = sm.OLS(y, X1).fit()
summary1 = model1.summary()

summary1
🧮 Wyniki modelu
| Wskaźnik | Wartość |
|---|---|
| R² | 0.610 |
| Skorygowany R² | 0.607 |
| F-statystyka | 243.9 (p < 0.001) |
| Liczba obserwacji | 158 |
| Współczynnik dla PKB per capita | 2.218 (p < 0.001) |
| Wyraz wolny (const) | 3.499 |
📊 Interpretacja
- Model wyjaśnia około 61% zróżnicowania poziomu szczęścia między krajami.
- Zmienna
Economy (GDP per Capita)ma bardzo silny i dodatni wpływ – im wyższy PKB na mieszkańca, tym wyższy wynik szczęścia. - Współczynnik 2.22 oznacza, że wzrost o 1 jednostkę wskaźnika ekonomicznego przekłada się średnio na wzrost wyniku szczęścia o 2.218 punktu (w skali 0–10).
- Wartość p < 0.001 wskazuje, że zależność jest statystycznie istotna.
💬 Krótkie podsumowanie
W 2015 roku różnice w zamożności krajów tłumaczą ponad połowę różnic w deklarowanym poziomie szczęścia.
Sam czynnik ekonomiczny okazuje się więc bardzo silnym predyktorem, ale z pewnością nie jedynym. Dlatego w kolejnym kroku sprawdzimy, czy dodanie czynników społecznych (rodzina, zdrowie) poprawi dopasowanie modelu.
Model 2 – czynniki społeczne
Poniższy kod oblicza wyniki modelu regresji po dodaniu czynników społecznych
# Model 2: PKB + czynniki społeczne (Family, Health)
X2 = df[["Economy (GDP per Capita)", "Family", "Health (Life Expectancy)"]]
X2 = sm.add_constant(X2)

model2 = sm.OLS(y, X2).fit()
summary2 = model2.summary()

# Porównanie R² między modelem 1 i 2
r2_comparison = {
    "Model 1 R²": model1.rsquared,
    "Model 2 R²": model2.rsquared,
    "ΔR²": model2.rsquared - model1.rsquared
}

summary2, r2_comparison
🧮 Wyniki modelu 2
| Wskaźnik | Wartość |
|---|---|
| R² | 0.727 |
| Skorygowany R² | 0.722 |
| ΔR² (wzrost względem Modelu 1) | +0.118 |
| F-statystyka | 137.0 (p < 0.001) |
| Liczba obserwacji | 158 |
📊Interpretacja modelu 2
| Zmienna | Współczynnik β | p-wartość | Interpretacja |
|---|---|---|---|
| Economy (GDP per Capita) | 0.888 | < 0.001 | wpływ ekonomiczny nadal istotny, lecz mniejszy po dodaniu czynników społecznych |
| Family | 1.697 | < 0.001 | silny dodatni wpływ – kraje z większym wsparciem społecznym są znacznie szczęśliwsze |
| Health (Life Expectancy) | 1.180 | 0.001 | dłuższe i zdrowsze życie sprzyja wyższemu poziomowi szczęścia |
PKB per capita: pozostaje istotnym predyktorem szczęścia (β = 0.888, p < 0.001), choć jego wpływ spadł w porównaniu z modelem 1 (β = 2.218).
Family: najsilniejszy czynnik w modelu 2 (β = 1.697, p < 0.001).
Health: również istotny (β = 1.180, p = 0.001).
Wzrost R² o 0.118 oznacza, że dodanie zmiennych społecznych znacząco poprawia dopasowanie modelu.
📘 Model 3 – pełny model szczęścia
# Model 3: ekonomiczne + społeczne + psychologiczne/kulturowe
X3 = df[[
    "Economy (GDP per Capita)", "Family", "Health (Life Expectancy)",
    "Freedom", "Trust (Government Corruption)", "Generosity"
]]
X3 = sm.add_constant(X3)

model3 = sm.OLS(y, X3).fit()

# Porównanie R² między modelami 1, 2, 3
r2_comparison_all = {
    "Model 1 R²": round(model1.rsquared, 3),
    "Model 2 R²": round(model2.rsquared, 3),
    "Model 3 R²": round(model3.rsquared, 3),
    "ΔR² (2→3)": round(model3.rsquared - model2.rsquared, 3)
}

summary3 = model3.summary()
summary3, r2_comparison_all
| Wskaźnik | Wartość |
|---|---|
| R² | 0.777 |
| Skorygowany R² | 0.768 |
| ΔR² (vs. Model 2) | +0.050 |
| F-statystyka | 87.810 (p < 0.001) |
| N = 158 |
📊Interpretacja modelu 3
Poniższa tabela przedstawia wyniki pełnego modelu regresji hierarchicznej (Model 3), w którym uwzględniono czynniki ekonomiczne, społeczne oraz psychologiczno-kulturowe. Współczynniki β pokazują kierunek i siłę wpływu poszczególnych predyktorów na poziom szczęścia (Happiness Score), przy kontrolowaniu pozostałych zmiennych.
Kolumny zawierają wartości współczynników nieznormalizowanych (β), błędy standardowe (SE), statystyki t oraz odpowiadające im poziomy istotności (p).
Wartości p < 0.05 wskazują na statystycznie istotny wpływ danego czynnika.
| Zmienna | β | SE | t | p |
|---|---|---|---|---|
| Stała (const) | 1.860 | 0.190 | 9.766 | < 0.001 |
| Economy (GDP per Capita) | 0.861 | 0.220 | 3.907 | < 0.001 |
| Family | 1.409 | 0.223 | 6.327 | < 0.001 |
| Health (Life Expectancy) | 0.975 | 0.316 | 3.084 | 0.002 |
| Freedom | 1.333 | 0.385 | 3.463 | 0.001 |
| Trust (Government Corruption) | 0.785 | 0.437 | 1.797 | 0.074 |
| Generosity | 0.389 | 0.391 | 0.995 | 0.321 |
📊 Porównanie modeli
| Model | Zmienne w modelu | R² | ΔR² |
|---|---|---|---|
| 1 | Economy (GDP) | 0.610 | – |
| 2 | + Family, Health | 0.727 | +0.118 |
| 3 | + Freedom, Trust, Generosity | 0.777 | +0.050 |
🧩 Interpretacja
- Po dodaniu czynników psychologicznych i kulturowych dopasowanie modelu wzrosło o kolejne 0.050 punktu R².
- Freedom (β = 1.333, p = 0.001) okazała się bardzo silnym predyktorem — swoboda wyborów życiowych znacząco zwiększa poziom szczęścia.
- Trust (β = 0.785, p = 0.074) jest na granicy istotności — zaufanie do instytucji może mieć wpływ, ale niepewny statystycznie.
- Generosity (β = 0.389, p = 0.321) nie osiągnęła istotności – hojność sama w sobie nie tłumaczy różnic między krajami.
- PKB, zdrowie i relacje społeczne pozostają istotne nawet po uwzględnieniu czynników psychologicznych.
💬 Podsumowanie
Wskaźniki ekonomiczne stanowią silną bazę wyjaśniania różnic w poziomie szczęścia,
jednak czynniki społeczne i psychologiczne wnoszą istotną wartość dodaną.
Łącznie model 3 wyjaśnia ponad 77% zróżnicowania w poziomie szczęścia między krajami świata w 2015 roku.
Wnioski końcowe
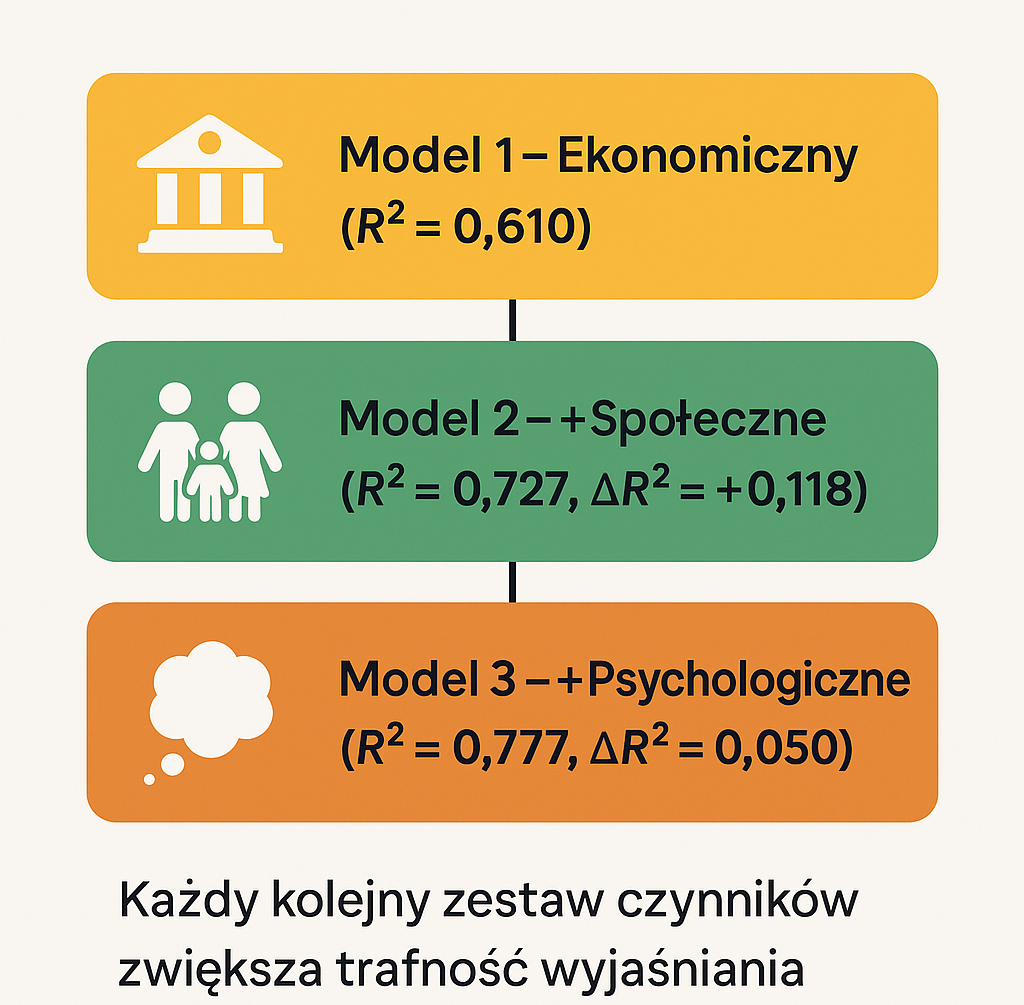
Regresja hierarchiczna polega na stopniowym dodawaniu grup zmiennych objaśniających i obserwowaniu, czy dopasowanie modelu (R²) poprawia się po każdym kroku.
- Wartość R² mówi, jak dobrze zmienne niezależne „tłumaczą” zmienność zmiennej zależnej.
Im bliższe 1, tym lepiej model dopasowuje się do danych. - W naszym przykładzie model 1 (tylko ekonomiczny) wyjaśniał 61% zróżnicowania poziomu szczęścia.
Po dodaniu czynników społecznych dopasowanie wzrosło do 73%,
a po dodaniu psychologicznych – do 78%. - Oznacza to, że każdy kolejny zestaw czynników wnosi dodatkowe informacje, które pomagają lepiej zrozumieć, od czego naprawdę zależy szczęście społeczeństw.
Innymi słowy:
Model 3 ma najwyższe R², więc jest najlepiej dopasowany,
ale dopiero porównanie wszystkich modeli – ΔR² (czytane: „delta R kwadrat”) – pokazuje, które czynniki najbardziej poprawiają trafność wyjaśniania.
💬 Uwagi terminologiczne
W literaturze można spotkać dwa różne znaczenia pojęcia regresja hierarchiczna.
W niniejszym wpisie używam go w sensie „hierarchicznego wprowadzania zmiennych do modelu” (ang. hierarchical entry regression),
czyli metody pozwalającej ocenić, czy dodanie kolejnych grup czynników poprawia dopasowanie modelu.
Nie należy tego mylić z modelami wielopoziomowymi (multilevel models),
które również bywają określane jako hierarchical, lecz dotyczą danych zagnieżdżonych (np. uczniów w szkołach, pracowników w firmach).
📘 Hierarchical vs. Stepwise Regression — na czym polega różnica?
Regresja hierarchiczna (hierarchical regression) polega na świadomym, teoretycznie uzasadnionym dodawaniu grup zmiennych w kolejnych krokach modelu.
Badacz sam decyduje, które czynniki wprowadzić najpierw (np. ekonomiczne), a które później (np. społeczne, psychologiczne), aby sprawdzić, jak zmienia się dopasowanie modelu (ΔR²).
To podejście służy testowaniu hipotez i pokazuje wartość dodaną kolejnych grup predyktorów.
Regresja krokowa (stepwise regression) natomiast jest metodą automatycznej selekcji zmiennych — program dodaje lub usuwa predyktory według kryteriów statystycznych (np. wartości p, AIC, BIC).
Celem jest znalezienie najbardziej „ekonomicznego” modelu, ale bez koniecznego oparcia w teorii.
| Cecha | Regresja hierarchiczna | Regresja krokowa |
|---|---|---|
| Kolejność zmiennych | Ustalana przez badacza | Wyznaczana automatycznie |
| Kryterium wyboru | Założenia teoretyczne | Statystyki (p-value, AIC/BIC) |
| Cel | Ocena przyrostu R² po dodaniu grup zmiennych | Wybór najlepszego zestawu predyktorów |
| Typ kontroli | Pełna kontrola badacza | Algorytmiczna selekcja |
📚 Przydatne źródła:
- Field, A. (2018). Discovering Statistics Using IBM SPSS Statistics (5th ed.). Sage.
→ Rozdział 8: „Hierarchical and Stepwise Multiple Regression” - Tabachnick, B. G., & Fidell, L. S. (2019). Using Multivariate Statistics (7th ed.). Pearson.
→ Sekcja 5.4: „Hierarchical versus Stepwise Approaches” - Pallant, J. (2020). SPSS Survival Manual (7th ed.). Open University Press.
→ Rozdział: „Multiple Regression”
Dodaj komentarz