Ten tekst zaczyna się od żaby i koloru zielonego, a kończy na bardzo przyziemnym wniosku: w uczeniu maszynowym nie wygrywa najmodniejszy algorytm, tylko ten najlepiej dopasowany do problemu.
Inspiracja
Inspiracją do poniższego eksperymentu był przykład zaproponowany przez prof. Dragana w książce Quo vAIdis, w którym klasyfikacja obiektów na podstawie składowych RGB została zilustrowana poprzez rozróżnianie „zielonej żaby” i „pomarańczowego orangutana”. Przykład ten pełni funkcję intuicyjnej metafory, mającej przybliżyć sposób działania sieci neuronowych osobom nietechnicznym.
W tym wpisie potraktowałam go jako punkt wyjścia do refleksji nad doborem narzędzi, a nie jako demonstrację „mocy” sieci neuronowych. Celem nie było zbudowanie możliwie najlepszego modelu, lecz sprawdzenie, jak różne algorytmy radzą sobie z bardzo prostym niskowymiarowym problemem (czyli takim, w którym obiekty opisane są niewielką liczbą cech — w tym przypadku trzema wartościami RGB oraz etykietą klasy).Oraz czy zastosowanie złożonych metod uczenia maszynowego jest w takim przypadku uzasadnione.
Konstrukcja zbioru danych
Zbiór danych wykorzystany w eksperymencie został skonstruowany ręcznie, w sposób celowo prosty i kontrolowany. Punktem wyjścia były ogólnodostępne tabele kodów kolorów w przestrzeni RGB, zawierające nazwy barw oraz odpowiadające im wartości składowych czerwonej (R), zielonej (G) i niebieskiej (B).
Z dostępnych kolorów wybrałam takie, które intuicyjnie kojarzą się z zielenią (żaba) oraz z odcieniami brązu i pomarańczu (orangutan). Nie chodziło przy tym o precyzyjne odwzorowanie biologicznej rzeczywistości, lecz o stworzenie symbolicznego, uproszczonego problemu klasyfikacyjnego, w którym różnice między klasami są oparte wyłącznie na barwie.
Każdy rekord w zbiorze danych składał się z trzech atrybutów numerycznych (R, G, B) oraz etykiety klasy („żaba” lub „orangutan”), przypisanej na podstawie subiektywnego podobieństwa koloru. Przykładowe rekordy wyglądały następująco:
| R | G | B | Skojarzenie |
|---|---|---|---|
| 0 | 255 | 0 | intensywna zieleń (żaba) |
| 50 | 205 | 50 | zieleń liści |
| 139 | 69 | 19 | brąz |
| 184 | 134 | 11 | złotawy brąz |
| 230 | 200 | 150 | jasny khaki |
| 255 | 0 | 0 | kolor graniczny |
Pełny zbiór obejmował kilkadziesiąt takich obserwacji, dobranych ręcznie tak, aby obejmowały zarówno przypadki jednoznaczne, jak i kolory graniczne, trudne do jednoznacznego przypisania do jednej klasy.
Już na etapie konstrukcji danych ujawniło się istotne ograniczenie tego podejścia: przypisanie etykiety klasy zależało od ludzkiej percepcji koloru, która nie jest stała. Odcienie beżu, khaki czy jasnego brązu zmieniały swoje skojarzenia w zależności od kontekstu, a nawet warunków wyświetlania — na przykład włączenia trybu nocnego monitora, który przesuwa barwy w stronę cieplejszych tonów.
Ten pozornie drobny detal ma istotne znaczenie metodologiczne. Model uczący się nie „widzi koloru” w sensie ludzkim — uczy się wyłącznie na podstawie etykiet, które sama mu dostarczam. Jeśli więc przypisanie klasy jest niejednoznaczne lub zależne od kontekstu, dokładnie ta niepewność zostaje następnie odtworzona w predykcjach modelu.
Wybór środowiska analitycznego
Do przeprowadzenia eksperymentu wybrałam środowisko Orange, przede wszystkim ze względu na jego wizualny charakter i niski próg wejścia. Orange pozwala budować kompletne pipeline’y analityczne poprzez łączenie gotowych komponentów, bez konieczności pisania kodu, co czyni go szczególnie użytecznym w pracy dydaktycznej oraz na etapie szybkiego prototypowania analiz.
Nie był to wybór przypadkowy. Z narzędzia tego korzystałam wcześniej w innych projektach badawczych i dydaktycznych, zwłaszcza do:
- eksploracji danych,
- klasteryzacji,
- oraz wizualizacji struktur danych przy użyciu metod takich jak MDS (Multidimensional Scaling).
W tym sensie Orange pełni dla mnie rolę środowiska do myślenia o danych, a nie wyłącznie do ich przetwarzania. Umożliwia szybkie sprawdzenie hipotez, porównanie algorytmów oraz obserwację wpływu poszczególnych decyzji (np. doboru cech czy metody klasyfikacji) na końcowy wynik.
W kontekście opisywanego eksperymentu miało to szczególne znaczenie. Celem nie było stworzenie zoptymalizowanego rozwiązania produkcyjnego, lecz zrozumienie zachowania różnych algorytmów przy identycznym zbiorze danych. Wizualny charakter Orange sprzyja takiej analizie, ponieważ pozwala śledzić cały proces krok po kroku — od przygotowania danych, przez uczenie modeli, aż po porównanie wyników.
W kontekście tego eksperymentu Orange pozwolił skupić się na porównaniu algorytmów i interpretacji wyników, bez rozpraszania uwagi na kwestie implementacyjne.
Przebieg eksperymentu
Eksperyment został zrealizowany w formie prostego pipeline’u uczenia maszynowego, obejmującego etapy przygotowania danych, uczenia modeli oraz porównania ich wyników. Cały proces został zbudowany w środowisku Orange poprzez łączenie kolejnych komponentów analitycznych.
Na etapie przygotowania danych wczytany zbiór został poddany podstawowemu przetwarzaniu (standaryzacja zmiennych), a następnie podzielony na część uczącą i testową przy użyciu losowego próbkowania. Ten sam podział danych był następnie wykorzystywany przez wszystkie analizowane algorytmy, co umożliwiło ich bezpośrednie porównanie.
W dalszym kroku zastosowano trzy różne metody klasyfikacji: sieć neuronową, regresję logistyczną oraz las losowy. Każdy z modeli był trenowany na tej samej części danych uczących, a jego skuteczność oceniana na zbiorze testowym przy użyciu standardowych miar jakości klasyfikacji.
Schemat całego procesu przedstawiłam na rysunku.
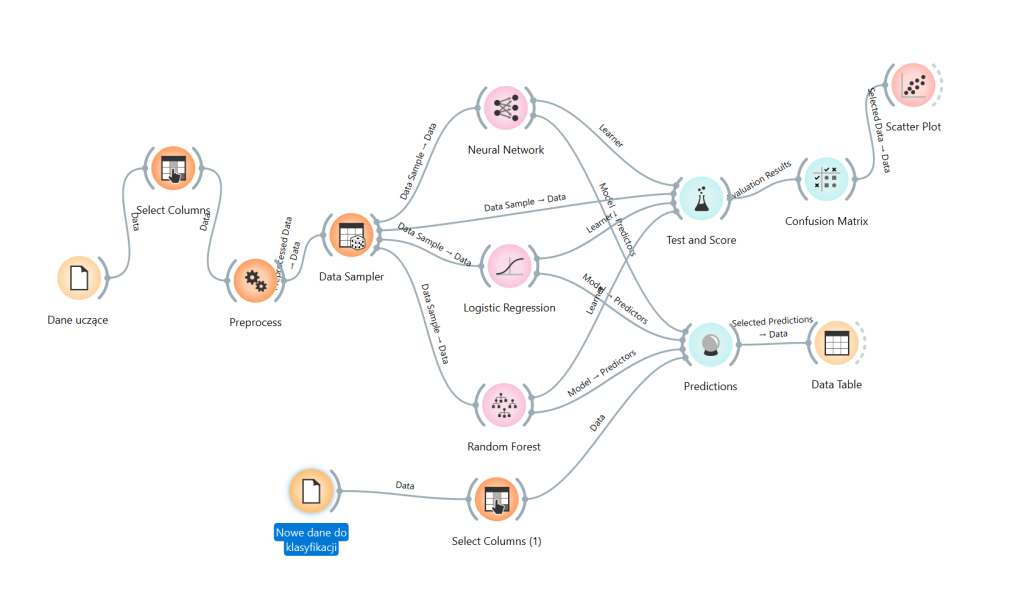
W schemacie analizy rozróżniono zbiór danych wykorzystywany do uczenia i oceny modeli oraz osobny zbiór nieoznaczonych obserwacji, użyty wyłącznie do demonstracji działania klasyfikatora na nowych danych.
Wyniki eksperymentu
W celu oceny przydatności różnych algorytmów do problemu klasyfikacji kolorów porównałam trzy metody: sieć neuronową, regresję logistyczną oraz las losowy. Wszystkie modele były trenowane i testowane na tym samym zbiorze danych, z wykorzystaniem identycznego podziału na dane uczące i testowe, co umożliwiło bezpośrednie porównanie wyników.
Oceny dokonano przy użyciu standardowych miar jakości klasyfikacji, takich jak dokładność (accuracy), miara F1 oraz pole pod krzywą ROC (AUC).
Porównanie algorytmów
Uzyskane wyniki jednoznacznie pokazały, że najlepsze rezultaty w tym zadaniu osiągnęły modele klasyczne. Zarówno regresja logistyczna, jak i las losowy wyraźnie przewyższały sieć neuronową pod względem większości analizowanych miar.
Las losowy okazał się najskuteczniejszym algorytmem, osiągając najwyższe wartości AUC oraz stabilne wyniki klasyfikacji. Regresja logistyczna, mimo swojej prostoty, również radziła sobie bardzo dobrze, co sugeruje, że granica decyzyjna w tym problemie ma w dużej mierze charakter liniowy.
Sieć neuronowa, choć poprawnie uczyła się zależności między składowymi RGB a etykietami klas, nie uzyskała przewagi nad prostszymi metodami. Jej wyniki były wyraźnie słabsze, a predykcje cechowała większa niepewność, szczególnie w przypadku kolorów granicznych.
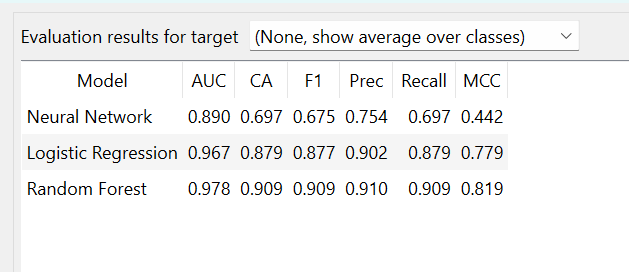
Porównanie modeli pokazuje, że w tym przypadku klasyczne metody (regresja logistyczna, las losowy) radzą sobie lepiej niż sieć neuronowa.
Predykcja na nowych danych
Dodatkowo sprawdzono działanie wytrenowanych modeli na niewielkim zbiorze nowych, nieoznaczonych obserwacji, obejmujących zarówno kolory jednoznacznie zielone, jak i barwy pośrednie (beże, khaki, odcienie żółtawe). W tym scenariuszu sieć neuronowa przypisywała większość obserwacji do klasy „żaba”, często z niewielką przewagą prawdopodobieństwa nad klasą przeciwną.
Analiza prawdopodobieństw predykcji ujawniła jednak, że nie był to efekt „błędu” modelu, lecz konsekwencja struktury zbioru uczącego. W danych treningowych nie występował bowiem stabilny, jednoznaczny wzorzec kolorystyczny odpowiadający klasie „orangutan”, co skutkowało przesunięciem granicy decyzyjnej w stronę klasy dominującej.
Interpretacja wyników
Uzyskane rezultaty potwierdzają, że zastosowanie bardziej złożonego algorytmu nie gwarantuje lepszych wyników, zwłaszcza w przypadku prostych, niskowymiarowych problemów. W analizowanym zadaniu klasyfikacji kolorów modele klasyczne okazały się nie tylko wystarczające, ale wręcz bardziej adekwatne niż sieć neuronowa.
Co istotne, sieć neuronowa nie „zawiodła” — jej zachowanie było spójne z jakością i charakterem danych. Eksperyment ten pokazuje jednak wyraźnie, że skuteczność algorytmu zależy przede wszystkim od struktury problemu, a nie od poziomu jego technicznego zaawansowania.
Podsumowanie
Celem opisanego eksperymentu nie było udowodnienie wyższości jednego algorytmu nad innymi, lecz sprawdzenie, jak różne metody uczenia maszynowego zachowują się w bardzo prostym, niskowymiarowym problemie klasyfikacyjnym. Przykład rozróżniania kolorów na podstawie składowych RGB okazał się wystarczająco prosty, by ujawnić różnice między modelami, a jednocześnie na tyle niejednoznaczny, by unaocznić ograniczenia danych i etykiet.
Uzyskane wyniki pokazują, że bardziej złożony algorytm nie musi prowadzić do lepszych rezultatów. W analizowanym zadaniu klasyczne metody — takie jak regresja logistyczna czy las losowy — okazały się nie tylko skuteczne, ale również stabilniejsze i łatwiejsze w interpretacji niż sieć neuronowa. Nie oznacza to, że sieci neuronowe są narzędziem niewłaściwym, lecz że ich zastosowanie powinno wynikać z charakteru problemu, a nie z samej dostępności technologii.
Eksperyment ten dobrze ilustruje jeszcze jedną, często pomijaną kwestię: modele uczące się nie działają w próżni. Ich zachowanie jest bezpośrednim odzwierciedleniem jakości danych, sposobu ich przygotowania oraz decyzji podejmowanych przez człowieka na etapie etykietowania. W tym sensie algorytm nie „rozpoznaje koloru” — uczy się jedynie powtarzać wzorce, które sami uznaliśmy za istotne.
W kontekście rosnącego zainteresowania rozwiązaniami opartymi na sztucznej inteligencji warto więc zachować ostrożność w doborze metod. Skuteczność analizy zależy nie od tego, jak zaawansowany algorytm wybierzemy, lecz od tego, czy jest on adekwatny do postawionego problemu. Czasem najlepszym rozwiązaniem okazuje się nie to najbardziej efektowne, lecz to najprostsze.
Dodaj komentarz