Nagrywanie głosu wydaje się dziś technicznie proste: dobry mikrofon, sprawdzony program, kilka minut ustawień. W praktyce szybko okazuje się, że jakość końcowego dźwięku zależy nie tylko od sprzętu, ale też od jego konfiguracji, sposobu mówienia i — co bywa zaskakujące — od samego procesu eksportu nagrania. Przy okazji pracy nad spokojną narracją głosową postanowiłam przyjrzeć się temu bliżej i sprawdzić, gdzie dokładnie pojawiają się różnice między odsłuchem a plikiem wyjściowym.
Ustawienia mikrofonu i sposób nagrywania
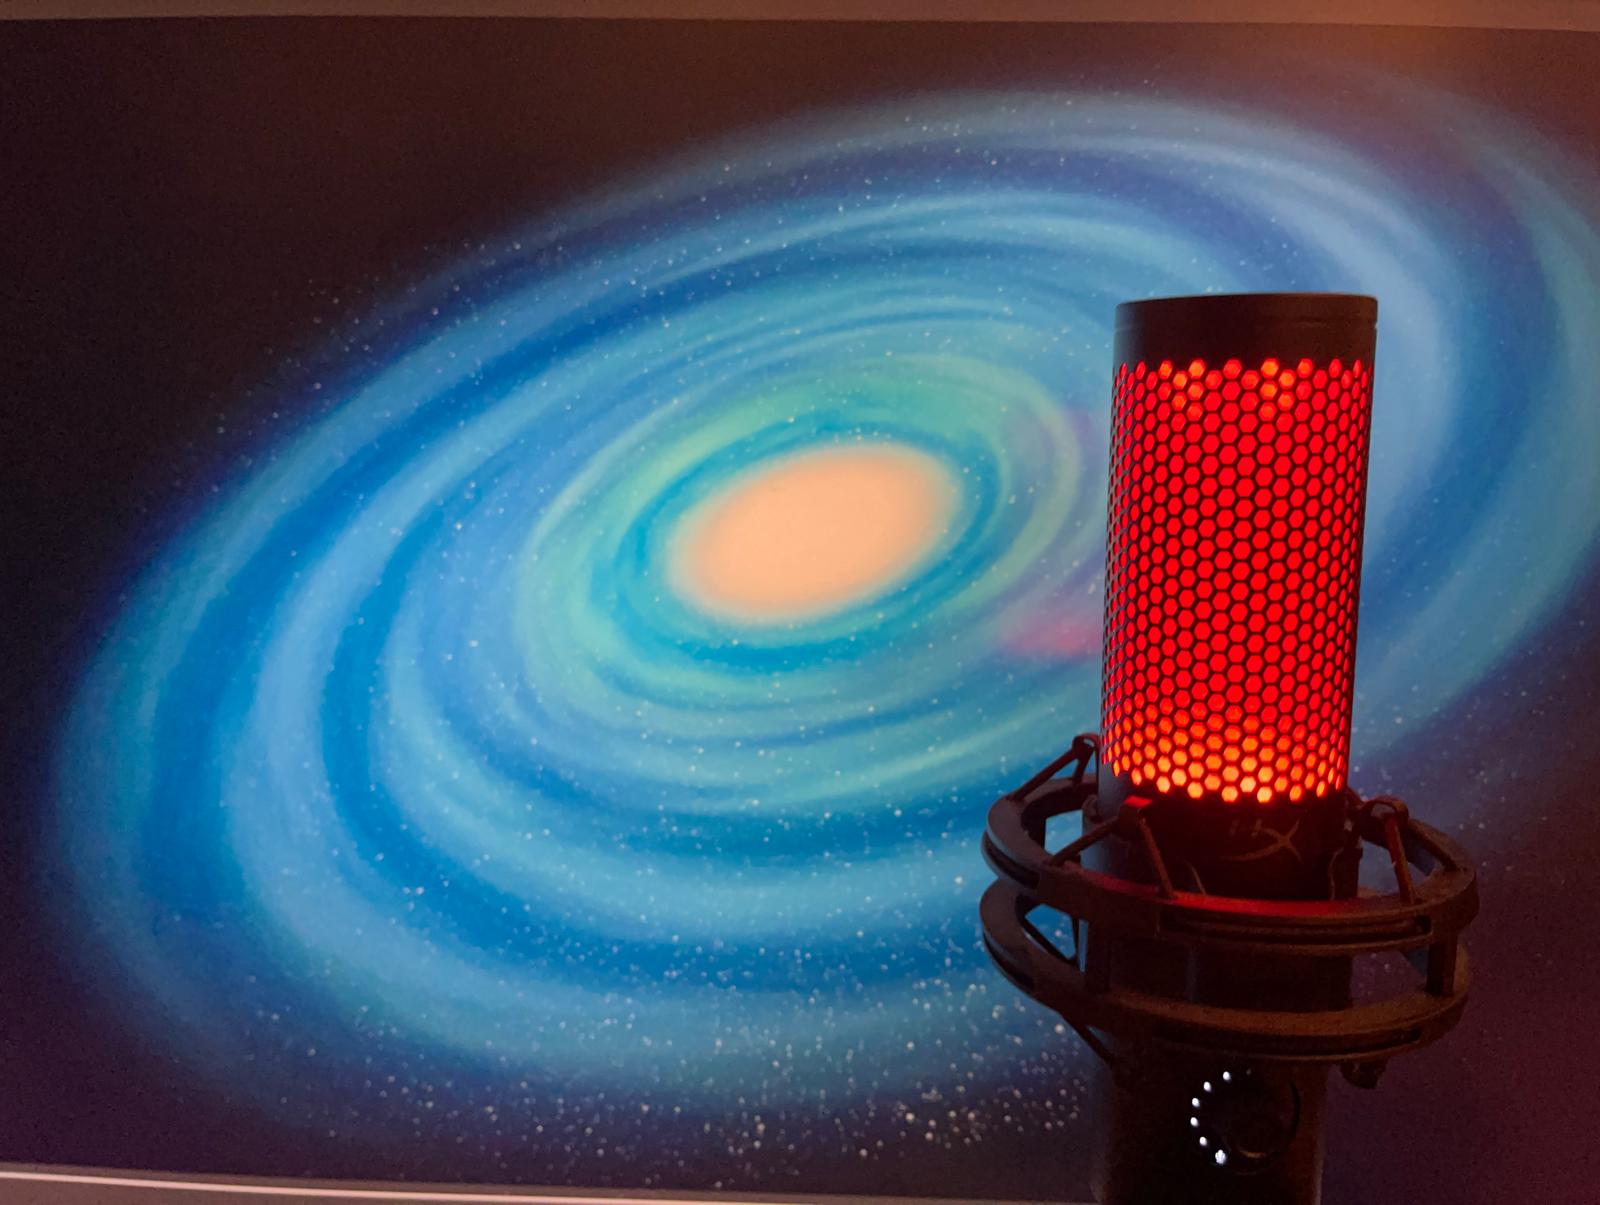
Mikrofon, z którego korzystałam – HyperX QuadCast 2, oferuje kilka trybów pracy. Do nagrania wybrałam tryb kardioidalny — przeznaczony do rejestracji głosu jednej osoby znajdującej się przed mikrofonem. To standardowy wybór przy nagraniach narracyjnych, ponieważ ogranicza zbieranie dźwięków z otoczenia.
Na dolnej części mikrofonu znajduje się także pokrętło z diodami LED, które odpowiada za poziom wzmocnienia sygnału (gain), czyli czułość mikrofonu. Ustawiłam je na wartość nieco poniżej połowy skali, tak aby uniknąć przesterowań i zbyt agresywnego zbierania dźwięku.
Nagrywałam z odległości około 40–50 cm, nie mówiąc bezpośrednio „w osi” mikrofonu, lecz pod lekkim kątem. Taki układ często pomaga ograniczyć głoski wybuchowe i daje bardziej naturalne brzmienie.
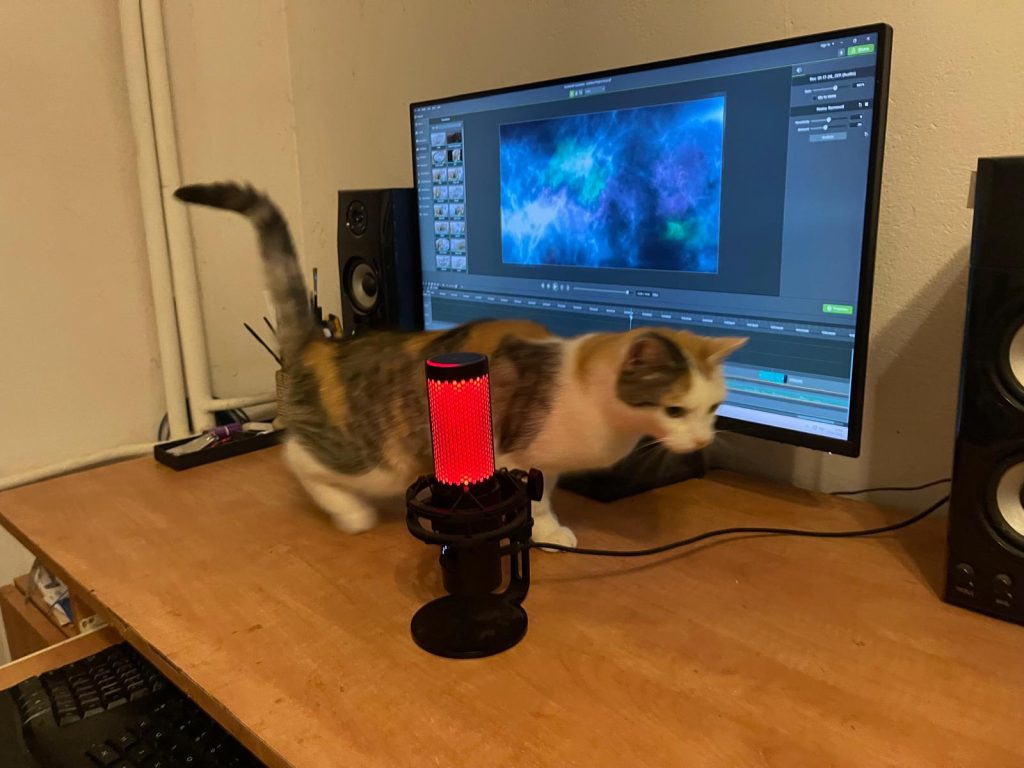
Nagranie powstało w zwykłym pomieszczeniu domowym, bez adaptacji akustycznej, co miało istotny wpływ na charakter rejestrowanego dźwięku.
Audacity – dobre doświadczenia, ale w innym zastosowaniu
Pierwszym wyborem był Audacity — program, którego wcześniej z powodzeniem używałam do nagrywania dźwięku z keyboardu. W tamtym kontekście sprawdzał się bez zarzutu, dlatego naturalnie sięgnęłam po niego również przy nagraniu głosu.
Odsłuch bezpośrednio w Audacity brzmiał poprawnie i nie wzbudzał większych zastrzeżeń. Problemy pojawiły się dopiero na etapie eksportu.
Eksport, który zmienił wszystko
Zarówno pliki MP3, jak i WAV po eksporcie brzmiały zauważalnie gorzej niż materiał odsłuchiwany w programie: pojawiło się więcej syczenia, a głos stracił naturalną miękkość. Co istotne, różnice były słyszalne nie tylko na komputerze, ale także po odsłuchu na innych urządzeniach.
W tym momencie stało się jasne, że problem nie leży wyłącznie w samym nagraniu, ale w całym torze: od rejestracji, przez przetwarzanie, po sposób zapisu pliku.
Camtasia jako nieoczywiste rozwiązanie
Po kilku nieudanych próbach — i krótkiej przerwie na spacer — przyszło mi do głowy rozwiązanie, które początkowo w ogóle nie było brane pod uwagę. Zamiast klasycznego programu audio sięgnęłam po Camtasię, którą mam od lat i której używałam głównie do nagrywania kursów e-learningowych i prezentacji.
Ku mojemu zaskoczeniu, nagranie wykonane w Camtasii brzmiało po eksporcie niemal identycznie jak w odsłuchu roboczym. Bez dodatkowych filtrów, bez ręcznego „ratowania” dźwięku i bez walki z parametrami eksportu. W tym konkretnym przypadku okazało się to rozwiązaniem znacznie stabilniejszym.
Wnioski
To doświadczenie bardzo wyraźnie pokazało mi, że jakość dźwięku nie jest prostą funkcją ceny sprzętu ani nawet samego nagrania. Ostateczny efekt zależy od całego toru: ustawień mikrofonu, sposobu mówienia, użytego oprogramowania oraz — co bywa pomijane — sposobu eksportu pliku.
Mikrofon, z którego korzystałam, działa poprawnie i zgodnie ze specyfikacją, ale jego czułość sprawia, że w przypadku spokojnych narracji wymaga szczególnie dobranego toru nagraniowego. Audacity, które świetnie sprawdzało mi się przy nagraniach instrumentalnych, w tym scenariuszu okazało się mniej przewidywalne na etapie eksportu.
Zaskakująco dobre rezultaty dała Camtasia — narzędzie, które pierwotnie nie było projektowane jako program stricte audio. W tym przypadku kluczowa okazała się spójność między odsłuchem roboczym a plikiem końcowym oraz brak konieczności agresywnej obróbki.
Najważniejszy wniosek jest jednak prosty: narzędzia warto dobierać do konkretnego celu i typu nagrania, a nie do utartych schematów. Czasem rozwiązanie „nieoczywiste” okazuje się najbardziej stabilne.
Dodaj komentarz